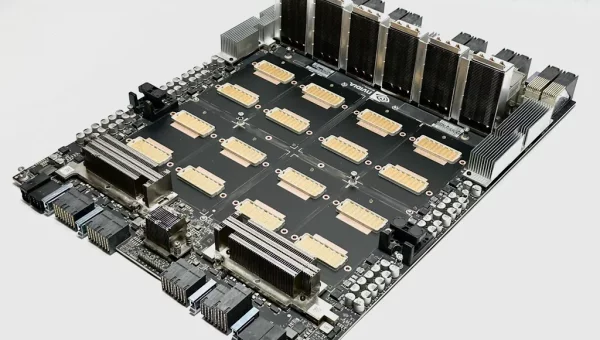
Baidu Kunlun (XT1 / XT2) — специализированные решения для инференса и NLP
В то время как рынок фокусируется на универсальных GPU для обучения гигантских моделей, существует огромный пласт корпоративных задач, где требуется не обучение, а массовый, энергоэффективный вывод (inference): распознавание речи в колл-центрах, видеоаналитика на производстве или ранжирование поисковых запросов.
Для этих задач универсальные GPU (вроде NVIDIA A100) часто являются избыточными и экономически неэффективными. Здесь на сцену выходят специализированные процессоры XPU (eXtensible Processing Unit), ярким представителем которых является линейка Baidu Kunlun (XT1 и XT2). Это «тёмная лошадка» рынка, предлагающая выдающуюся плотность вычислений на ватт при глубокой интеграции с экосистемой PaddlePaddle.
Аппаратная часть — эволюция от XT1 к XT2
Чипы Kunlun разрабатываются с прицелом на конкретные алгоритмы, а не на универсальность, что позволяет оптимизировать кремний под матричные вычисления и обработку естественного языка (NLP).
Kunlun XT1 (14 нм)
Первое поколение, доказавшее жизнеспособность архитектуры. Предлагает до 128 TFLOPS в формате FP16 и 256 TOPS в INT8. Отлично зарекомендовал себя в задачах компьютерного зрения и базового NLP.
Kunlun XT2 (7 нм)
Флагманское решение второго поколения. Переход на 7-нм техпроцесс позволил увеличить производительность в 2–3 раза при сохранении или даже снижении тепловыделения (TDP).
- Поддержка форматов FP16, INT8 и INT4 (квантование), что критически важно для современного инференса LLM
- Интеграция высокоскоростной памяти HBM2 с пропускной способностью до 512 ГБ/с, что устраняет «узкое горлышко» памяти при работе с большими моделями
- Форм-фактор: стандартная плата PCIe (полная высота, половинная длина), что кардинально упрощает интеграцию в существующие x86-серверы по сравнению с проприетарными форм-факторами OAM или SXM
Общий обзор форм-факторов: Рынок серверных ИИ-ускорителей — NVIDIA SXM, Huawei Atlas и Baidu Kunlun.
Программный стек — PaddlePaddle как фундамент
Главная особенность Kunlun — его неразрывная связь с фреймворком глубокого обучения PaddlePaddle (разработка Baidu). Это не просто «железо», это вертикально интегрированный стек.
Paddle Inference
Высокопроизводительный движок вывода, оптимизированный специально под архитектуру XPU. Он автоматически применяет графовые оптимизации, слияние операторов и квантование, выжимая максимум производительности из чипа.
Проблема миграции с CUDA
В отличие от NVIDIA, Kunlun не поддерживает CUDA нативно. Есть два пути работы с моделями:
- Путь А (идеальный): использование моделей, уже обученных или экспортированных в PaddlePaddle (включая знаменитую модель ERNIE от Baidu)
- Путь Б (конвертация): использование инструментов Baidu для конвертации моделей из ONNX (PyTorch/TensorFlow) в формат Paddle. Это работает для стандартных архитектур (ResNet, BERT, YOLO), но может потребовать доработки для кастомных слоёв
Kunlun Core Software Stack
Включает компиляторы и драйверы, которые управляют распределением задач между вычислительными ядрами XPU.
Экономическая целесообразность и сценарии применения
Почему бизнес выбирает Kunlun вместо более привычных решений?
Высокая плотность инференса на доллар/ватт
Для задач, где нужно обрабатывать тысячи запросов в секунду (например, транскрибация звонков или модерация видеопотока), стойка с платами Kunlun XT2 потребляет значительно меньше электроэнергии и занимает меньше места, чем аналогичная по производительности стойка на универсальных GPU.
ИИ-колл-центры и голосовые ассистенты
Архитектура XPU исторически оптимизирована под задачи NLP (Transformer-модели), что делает её идеальной для ASR (распознавание речи) и TTS (синтез речи) в режиме 24/7.
Компьютерное зрение (CCTV)
Платы Kunlun эффективно справляются с параллельным запуском множества лёгких моделей детекции объектов (например, YOLO) на одном физическом устройстве.
Стартапы и SMB с ограниченным бюджетом
Когда аренда облачных GPU NVIDIA слишком дорога, а покупка б/у SXM-модулей сопряжена с рисками — новые платы Kunlun с официальной гарантией становятся привлекательной альтернативой «золотой середины».
Чек-лист проверки б/у SXM: Вторичный рынок NVIDIA SXM.
Интеграция в существующую ИТ-инфраструктуру
Огромным преимуществом Kunlun перед некоторыми другими альтернативными архитектурами является его стандартный форм-фактор PCIe.
Для внедрения не требуется закупать специализированные серверные шасси с жидкостным охлаждением или поддержкой OAM. Плата Kunlun XT2 вставляется в стандартный слот PCIe Gen4 x16 в обычном сервере Dell, HPE или Supermicro, после чего устанавливается драйвер Baidu и фреймворк PaddlePaddle. Это снижает порог входа и время на развёртывание (Time-to-Market).
Связанные материалы
- Рынок серверных ИИ-ускорителей — обзор
- Huawei Atlas (Ascend 910/310) — суверенное ИИ-железо
- Вторичный рынок NVIDIA SXM — чек-лист проверки
- Промышленные сети и IIoT шлюзы
Перейти в каталог
Оставить заявку на спецификацию и тестовый стенд Baidu Kunlun: форма подбора.