Huawei Atlas (Ascend 910/310) — суверенная альтернатива для корпоративного ИИ
В условиях ограничений на поставки передовых GPU NVIDIA экосистема Huawei Atlas на базе процессоров Ascend стала де-факто стандартом для построения суверенных вычислительных кластеров в России и странах СНГ.
В отличие от попыток адаптировать потребительские видеокарты для серверных задач, Huawei предлагает законченную enterprise-архитектуру: от специализированных кремниевых решений (NPU — Neural Processing Unit) до серверных шасси и собственного программного стека. Однако переход на эту платформу требует чёткого понимания двух независимых, но связанных компонентов: аппаратной части (железо) и программной экосистемы (софт).
Аппаратная часть — Ascend 910 для обучения и Ascend 310 для инференса
Архитектура Ascend построена на специализированных матричных сопроцессорах (Da Vinci Architecture), оптимизированных под операции тензорного умножения, которые лежат в основе нейросетей.
Ascend 910 / 910B (серверы Atlas 800) — уровень обучения (Training)
- Позиционирование: прямой конкурент NVIDIA A100 в задачах обучения и дообучения (fine-tuning) больших языковых моделей (LLM) и компьютерного зрения
- Характеристики: чипы Ascend 910B оснащаются 64 ГБ или 128 ГБ высокоскоростной памяти HBM2e с пропускной способностью до 390–400 ГБ/с. Вычислительная мощность в формате FP16 достигает 312 TFLOPS, что сопоставимо или превосходит показатели A100 в специфических AI-нагрузках
- Интерконнект: поддержка технологии HCCS (Huawei Cache Coherent System) — аналога NVLink, обеспечивающей скорость обмена данными между чипами до 392 ГБ/с, что критично для распределённого обучения на кластерах Atlas 800 (модели 9000 A2/N2)
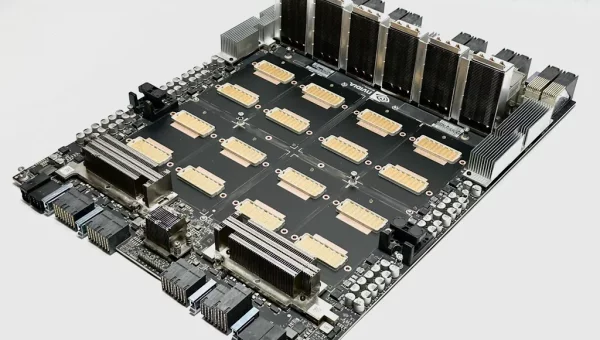
- Форм-фактор: поставляется в виде готовых серверов Atlas 800 (на 8 NPU) или в виде OAM-модулей для интеграции в сторонние серверные платформы
Ascend 310 / 310P (ускорители Atlas 300 / 500) — уровень вывода (Inference)
- Позиционирование: высокоэффективные PCIe-карты для деплоя уже обученных моделей
- Характеристики: низкое энергопотребление (около 70–80 Вт) при высокой плотности инференса. Идеальны для потоковой видеоаналитики, обработки естественного языка (NLP) в реальном времени и рекомендательных систем
- Форм-фактор: стандартные PCIe-карты половинной или полной высоты (Atlas 300V / 300I Pro), легко интегрируемые в существующие серверы x86 или ARM-архитектуры
Общий обзор рынка: Рынок серверных ИИ-ускорителей — NVIDIA SXM, Huawei Atlas и Baidu Kunlun.
Программный стек — CANN и MindSpore
Главный вызов и одновременно главное преимущество экосистемы Huawei — это её замкнутость и независимость от западных лицензий. Программная часть делится на два ключевых уровня.
CANN (Compute Architecture for Neural Networks)
Это базовый уровень, прямой аналог NVIDIA CUDA. CANN предоставляет набор библиотек высокопроизводительных ядер (например, AscendCL), компиляторы и драйверы, которые транслируют код нейросети в машинные инструкции для NPU Ascend.
MindSpore
Собственный фреймворк глубокого обучения от Huawei, созданный как альтернатива PyTorch и TensorFlow. Он поддерживает автоматическое дифференцирование, распределённое обучение и оптимизирован для работы с CANN «из коробки».
Реальность миграции с CUDA — вызовы и инженерные решения
Переход с NVIDIA на Huawei Atlas редко бывает «plug-and-play». Инженерным командам необходимо заложить время на адаптацию (Time-to-Market). Существует три основных пути миграции.
Путь 1 — нативная разработка на MindSpore
- Плюсы: максимальная производительность, полная поддержка всех функций NPU
- Минусы: требует переписывания кода и переобучения моделей с нуля. Высокий порог входа для разработчиков, привыкших к PyTorch
Путь 2 — использование адаптера torch_npu (рекомендуемый для большинства)
Huawei разработала официальный плагин для PyTorch. В большинстве случаев для переноса существующего кода достаточно заменить в скрипте .cuda() на .npu() и импортировать torch_npu.
Нюанс: не все операции (ops) из последних версий PyTorch ещё портированы в torch_npu. Для кастомных слоёв может потребоваться написание собственных операторов на C++ с использованием Ascend C.
Путь 3 — автоматическая конвертация моделей (AMCT — Ascend Model Compression Toolkit)
Инструмент позволяет взять готовую модель в формате ONNX (экспортированную из PyTorch или TensorFlow) и скомпилировать её в формат .om (Offline Model), оптимизированный для выполнения на Ascend 310/910 без изменения исходного кода обучения.
Инфраструктурные преимущества для рынка РФ и СНГ
Несмотря на сложности миграции, выбор Atlas диктуется не только техническими, но и бизнес-факторами.
Гарантированные поставки и логистика
В отличие от серых поставок NVIDIA, оборудование Huawei поставляется официально, с полным пакетом документов, таможенной очисткой и гарантией вендора.
Локальная техническая поддержка
Наличие инженерных команд Huawei в регионе, способных помочь с оптимизацией CANN-кода и настройкой кластеров HCCS, что критично для enterprise-заказчиков.
Соответствие требованиям регуляторов
Серверы Atlas включаются в реестры Минпромторга (через локализацию или партнёрские сборки), что является обязательным требованием для госзакупок и критической информационной инфраструктуры (КИИ).
Сценарии применения
- Крупный финтех и телеком — построение суверенных LLM-ассистентов и систем скоринга на кластерах Atlas 800
- Безопасность и Smart City — потоковая обработка видео с тысяч камер на базе стоек с платами Atlas 300V (видеоаналитика)
- Промышленность и энергетика — развёртывание моделей предиктивного обслуживания (Predictive Maintenance) на периферии (Edge) с использованием компактных инференс-серверов
Связанные материалы
- Рынок серверных ИИ-ускорителей — обзор
- Baidu Kunlun (XT1/XT2) — архитектура XPU и PaddlePaddle
- Промышленные сети и IIoT шлюзы
- Стандарты надёжности и электропитания
- ПЛК Siemens SIMATIC и периферия Phoenix Contact
Перейти в каталог
Оставить заявку на архитектурный аудит перехода на Huawei Atlas: форма подбора.