Более десяти лет графические процессоры Nvidia были архитектурным фундаментом китайской индустрии искусственного интеллекта. Они обеспечивали работу поисковых систем, систем компьютерного зрения, автономного транспорта и, в конечном итоге, волны генеративных моделей (LLM). Однако ужесточение экспортного контроля со стороны США и появление ограниченных версий чипов (H800, A800, H20) изменили стратегический вектор.
К 2025–2026 годам курс на технологический суверенитет стал необратимым. Крупнейшие технологические компании Китая получили стимул не просто адаптироваться к ограничениям, а активно инвестировать в отечественные альтернативы. Главный вопрос для индустрии сместился с «Могут ли они создать чип?» на «Могут ли они предложить конкурентоспособную экосистему, включающую память, интерконнекты и программный стек?».
Ниже представлен технический анализ четырех ключевых игроков, которые формируют новую архитектуру ИИ-вычислений в Китае.
1. Huawei (Ascend): Инфраструктурный гигант с фокусом на кластеры
Huawei является наиболее очевидным и мощным претендентом на замещение решений Nvidia в корпоративном и государственном секторах. Линейка Ascend развивалась в условиях жестких санкций, что заставило компанию сделать ставку на вертикальную интеграцию.
- Текущее поколение (Ascend 910B / 910C): Чип 910B часто сравнивают с Nvidia A100. В ряде задач обучения он демонстрирует сопоставимую производительность, однако использование памяти HBM2e ограничивает его пропускную способность по сравнению с Nvidia H20. Новейший 910C представляет собой двухчиповую компоновку, которая в конфигурации кластера Atlas 900 A3 SuperPoD (384 чипа) достигает 300 PFLOPS, приближаясь к возможностям H100 в специфичных масштабируемых рабочих нагрузках.
- Дорожная карта (2026–2027): Huawei анонсировала переход на Ascend 950 (целевые показатели: 1 PFLOPS в формате FP8, 128–144 ГБ памяти, пропускная способность интерконнекта до 2,0 ТБ/с) и последующий Ascend 960.
- Программный стек: Ключевое преимущество Huawei — наличие полного стека: от низкоуровневого CANN (Compute Architecture for Neural Networks), выступающего альтернативой CUDA, до фреймворка глубокого обучения MindSpore.
- Объективное ограничение: Крупные облачные провайдеры и телеком-операторы часто диверсифицируют закупки, опасаясь чрезмерной вендорской зависимости (vendor lock-in) от единого поставщика.
2. Baidu (Kunlunxin): Прорыв в инференсе и открытая экосистема
История чипов Baidu началась с внутренних экспериментов с FPGA в 2011 году, что привело к созданию Kunlun 1 (14 нм) и Kunlun 2 (7 нм, с фокусом на инференс для автономного вождения Apollo). Однако настоящее преображение произошло с анонсом третьего поколения.
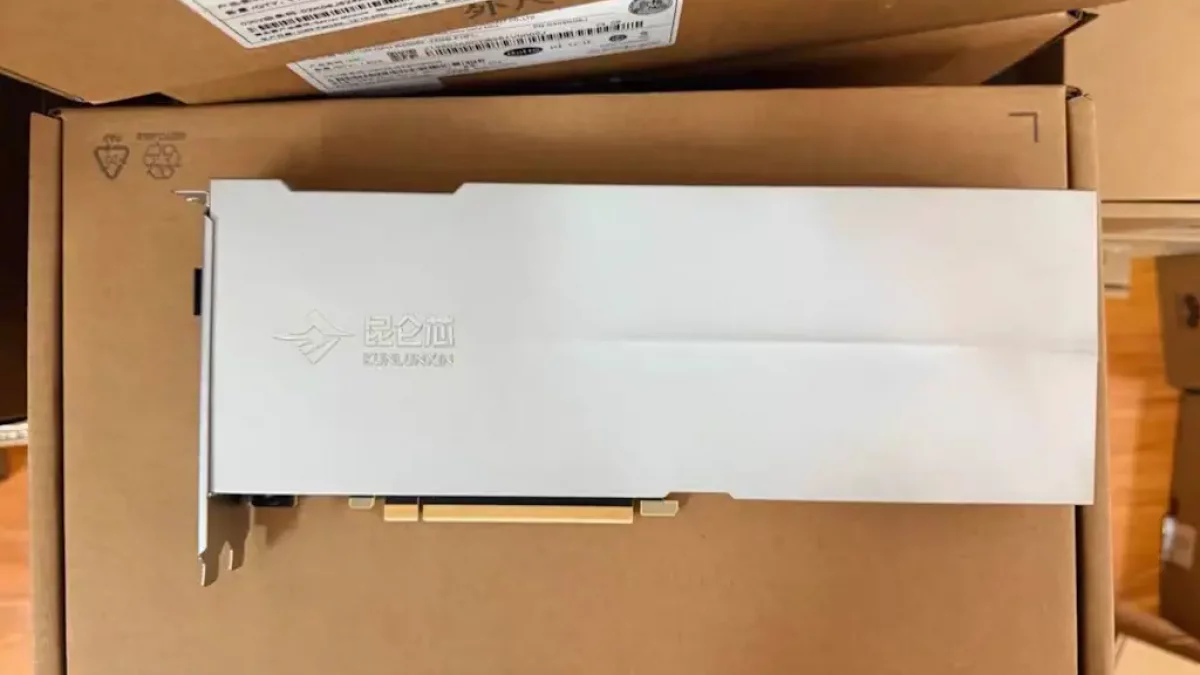
- Флагман Kunlun 3 (P800): Это специализированный AI-ускоритель, который стал прямым ответом на ограничения рынка.
- Вычислительная мощность: До 345 TFLOPS в формате FP16.
- Память и интерфейс: Конфигурации PCIe оснащаются 96 ГБ высокоскоростной памяти (HBM2e/HBM3) и интерфейсом PCIe 5.0, что обеспечивает отличную пропускную способность для загрузки крупных моделей.
- Программный прорыв (vLLM-Kunlun): Это главное конкурентное преимущество Baidu на текущем этапе. Компания выпустила официальный аппаратный плагин
vLLM-Kunlun, который позволяет бесшовно запускать популярные open-source модели (Qwen 2/2.5/3, DeepSeek V3/R1, Llama 3, GLM) без модификации исходного кода vLLM. Поддержка стандарта OpenAI API, квантования (W8A8, AWQ) и Multi-LoRA делает переход разработчиков на эту платформу максимально безболезненным. - Масштаб: Baidu уже эксплуатирует кластеры из более чем 30 000 чипов P800 для обучения собственных мультимодальных моделей семейства Qianfan.
3. Alibaba (T-Head): Облачно-ориентированный кремний
Подразделение T-Head (Pingtouge) изначально фокусировалось на архитектуре RISC-V, но быстро перешло к разработке специализированных ускорителей для собственных гигантских облачных инфраструктур.
- Эволюция: От чипа Hanguang 800 (2019 г., 12 нм, 820 TOPS для инференса) компания перешла к разработке нового процессора, часто обозначаемого как PPU (Processing Unit).
- Спецификации PPU: Новое решение позиционируется как прямой конкурент Nvidia H20. Оно оснащено 96 ГБ высокоскоростной памяти и поддерживает интерфейс PCIe 5.0, что критически важно для задач обработки больших языковых моделей в облаке.
- Инфраструктура: Alibaba интегрирует эти чипы в свои суперсерверы Panjiu нового поколения, которые поддерживают до 128 ускорителей на стойку с применением передового жидкостного охлаждения. Для Alibaba это вопрос не только производительности, но и гарантированной доступности вычислительных ресурсов для клиентов Alibaba Cloud вне зависимости от геополитической конъюнктуры.
4. Cambricon: Возвращение специализированного игрока
Cambricon, выделившаяся из Китайской академии наук, является одним из старейших и наиболее технологичных "чистых" разработчиков ИИ-чипов в стране. После периода финансовых трудностей и потери ключевого партнера (Huawei перешла на собственные Ascend), компания совершила впечатляющий камбэк.
- Линейка MLU: Эволюция от MLU 290 и MLU 370 (96 TFLOPS FP16) привела к выпуску MLU 590. Этот чип, созданный по 7-нм техпроцессу, обеспечивает производительность 345 TFLOPS (FP16) и, что важнее, внедряет поддержку форматов пониженной точности (FP8). Это снижает нагрузку на подсистему памяти и позволяет в ряде сценариев инференса конкурировать с Nvidia H20.
- Будущее (MLU 690): Ожидается, что следующее поколение значительно увеличит плотность вычислительных ядер и пропускную способность памяти, приближаясь к показателям Nvidia H100 в специфичных задачах.
- Статус: Компания вернулась к прибыльности, а ее решения все чаще встречаются в государственных тендерах и проектах крупных интеграторов, что подтверждает коммерческую жизнеспособность архитектуры.
Главный вызов: не кремний, а программный стек
Сырая вычислительная мощность (TFLOPS) — это лишь половина уравнения. Историческое доминирование Nvidia обусловлено не только железом, но и десятилетиями оптимизации стека CUDA.
Китайские разработчики сталкиваются с необходимостью адаптации кода под альтернативные фреймворки: CANN (Huawei), PaddlePaddle (Baidu) или проприетарные стеки. Именно поэтому такие инициативы, как vLLM-Kunlun или открытые драйверы для MLU, имеют стратегическое значение. Они создают слой абстракции, позволяющий инженерам использовать привычные инструменты (PyTorch, стандартные API), скрывая сложность низкоуровневой оптимизации под конкретный XPU или NPU.
Резюме
Китайская индустрия полупроводников для ИИ не ставит целью создать точную копию Nvidia H100 или B200 в кратчайшие сроки. Стратегия иная: создание достаточно хороших, масштабируемых и программно поддерживаемых решений (таких как кластеры на базе Kunlun P800 или Ascend 910C), которые позволяют обучать и развертывать модели уровня DeepSeek или Qwen автономно.
Гонка сместилась с уровня отдельных чипов на уровень системной интеграции: кто сможет предложить наиболее стабильный кластер, эффективное жидкостное охлаждение и бесшовную совместимость с открытыми фреймворками машинного обучения.